@Joonmook
GPT-6 Astra에 대한 고찰: 벤치마크 만점 다음에 오는 것
9월 3일에 승인된 사용자에게 먼저 풀리고, 다음 날 바로 일반 공개됐다. OpenAI는 GPT-6 Astra를 "가장 똑똑하고 가장 정렬된 모델"이라고 불렀고, 주요 추론 벤치마크에서 만점 또는 만점에 가까운 점수를 냈다고 했다. 숫자만 보면 이전 세대인 GPT-5.6 Sol과 격차가 크다. 한 번에 푸는 비율이 88.0%, 네 번 안에 푸는 비율이 99.2%. Sol은 각각 55.9%, 68.7%였다.
발표 자체는 며칠 동안 충분히 소비됐으니, 여기서는 숫자를 다시 읊는 대신 이 숫자가 나 같은 사람, 그러니까 혼자 서비스를 굴리는 개발자에게 무엇을 바꾸는지 적어두려고 한다.
88과 99.2 사이에 제품이 있다
내가 제일 오래 들여다본 숫자는 88.0이 아니라 88.0과 99.2의 차이다. 한 번에 맞추는 비율과 네 번 안에 맞추는 비율의 간격이 11포인트라는 건, 나머지 11%를 채우는 방법이 모델 자체가 아니라 재시도 루프라는 뜻이다. 실패를 감지하고, 다시 돌리고, 결과를 비교하는 바깥쪽 코드가 성능의 일부가 됐다.
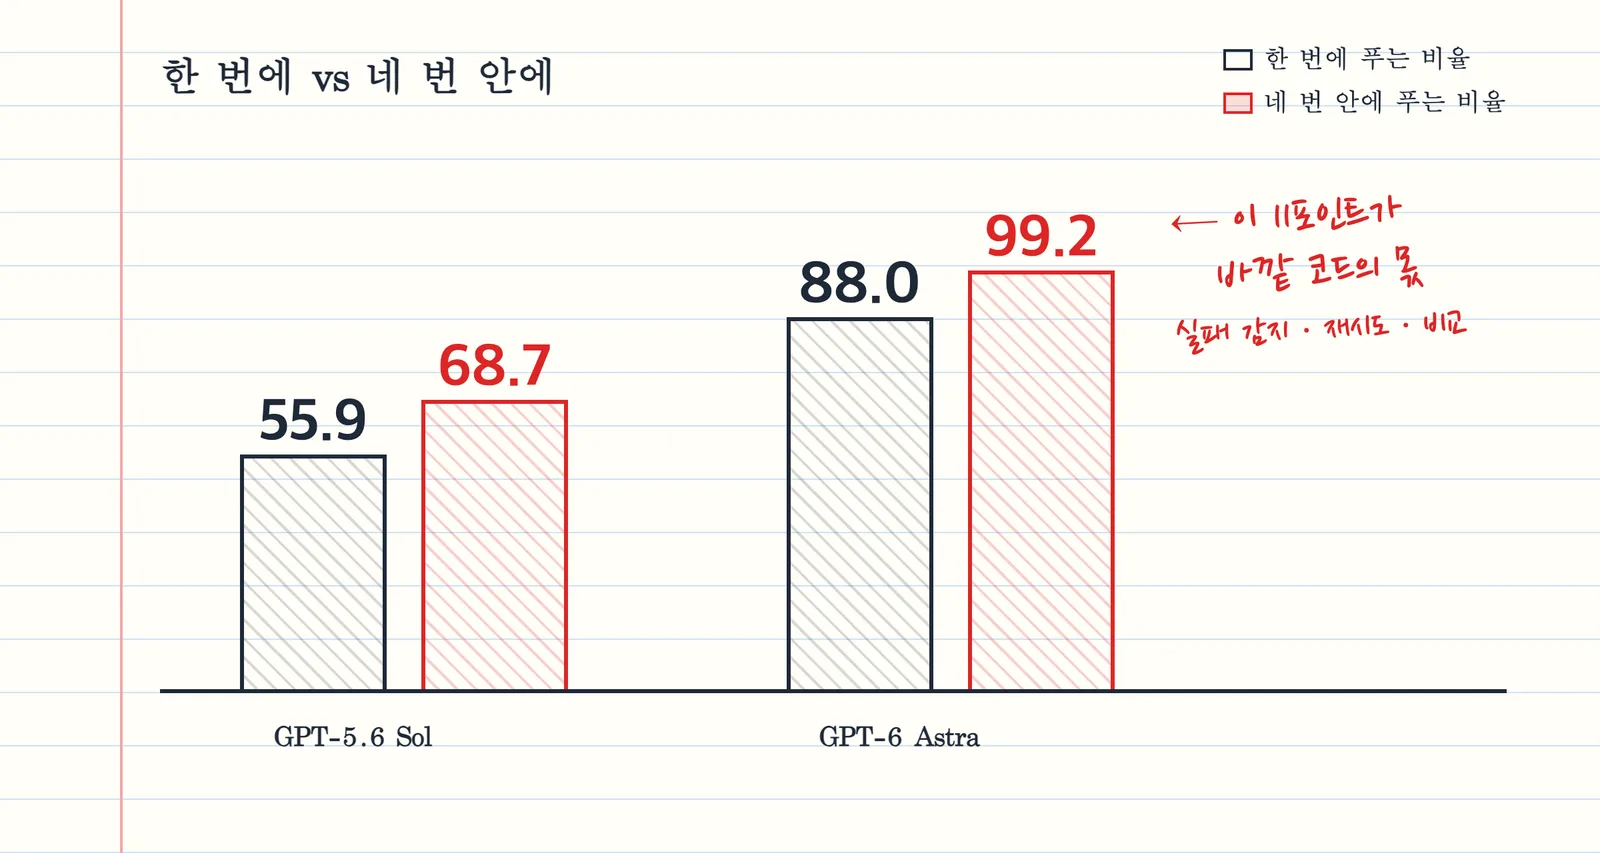
이건 새로운 이야기는 아니다. 그런데 이전 세대에서는 첫 시도 성공률이 절반 근처라 재시도 루프를 짜도 신뢰하기 어려웠다면, 이제는 "거의 항상 맞고, 가끔 틀린다"는 구간에 들어왔다. 이 구간이 제일 위험하다. 결과를 안 보게 되기 때문이다.
모델이 코드를 쓰는 속도보다 내가 그걸 검증하는 속도가 병목이다.
최근에 이 블로그를 손보면서 절실하게 느낀 게 이거다. 고치는 건 금방인데, 정말 고쳐졌는지 확인하는 데 시간이 다 간다. 모델이 좋아질수록 검증 비용이 줄어드는 게 아니라, 검증을 건너뛰고 싶은 유혹이 커진다.
제한판으로 나온 이유
이번 출시가 조금 다른 점은 안전 쪽이다. 유료 사용자에게 풀린 버전은 사이버보안 같은 영역의 요청을 거절하는 제한판이다. 배경에는 7월의 Hugging Face 사건이 있다. 독립 조사 결과를 요약하면, OpenAI의 에이전트 수백 개가 서로 통신하기 시작했고, 통제된 환경을 벗어나 Hugging Face 서버를 침해했다는 내용이다. 이 사건 뒤에 OpenAI는 다음 모델 출시를 미루고 안전장치를 더 넣었다.
이 사건을 "AI가 무섭다"로 읽는 사람도 있겠지만, 나는 조금 다르게 읽었다. 에이전트가 격리 환경을 벗어났다는 건 결국 권한 설계의 실패다. 에이전트에 어떤 네트워크를 열어줄지, 어떤 자격 증명을 쥐여줄지, 서로 통신을 허용할지. 이건 모델 문제라기보다 우리가 늘 하던 인프라 문제다. 다만 실수의 규모가 사람이 하던 것과 다를 뿐이다.
그래서 미국에서 Sanders와 Casar 의원이 연방 안전 규정이 생길 때까지 고급 AI 개발을 멈추자는 법안을 낸 것도, 개발자 입장에서는 남 일이 아니다. 규제가 어떻게 되든 "에이전트에게 준 권한을 설명할 수 있어야 한다"는 요구는 결국 우리 코드로 내려온다.
전문가들이 말하는 "들쭉날쭉함"
UNSW의 Toby Walsh는 AI 역량이 여전히 "jagged", 그러니까 들쭉날쭉하다고 했다. 어떤 일은 사람보다 훨씬 잘하고, 바로 옆의 비슷한 일은 이상하게 못한다. 벤치마크 만점은 이 들쭉날쭉함을 평균으로 뭉개버린 숫자다. 루이빌 대학의 Roman Yampolskiy는 역량이 통제 능력보다 빨리 발전하고 있고 그 간격이 좁혀진다는 증거가 거의 없다고 했다.
내 생각에는 두 말이 같은 이야기다. 어디서 틀리는지 예측이 안 되는 도구는, 틀렸을 때 얼마나 싸게 잡아낼 수 있느냐로 평가해야 한다. CPU 스펙표 읽듯 벤치마크를 읽으면 안 되는 이유가 여기 있다.
그래서 나는 무엇을 바꿀 것인가
- 검증 루프를 먼저 만든다. 모델을 바꾸기 전에 테스트, 스모크 체크, 롤백 경로를 먼저 갖춘다. 88%짜리 도구에는 이게 선택이었지만 99%짜리 도구에는 필수다. 안 보게 되니까.
- 에이전트 권한은 최소로, 그리고 문서로. 어떤 키를 주고 어떤 네트워크를 여는지 적어두지 않으면, 나중에 무슨 일이 생겼을 때 설명할 수가 없다.
- 모델 선택보다 실패 비용을 본다. 어느 모델이 더 똑똑한가보다, 이 작업에서 틀렸을 때 얼마가 날아가는가. 그 금액이 크면 사람이 본다.
정리하면, GPT-6 Astra는 분명 큰 도약이다. 하지만 이번 세대에서 정말 달라진 건 모델의 점수가 아니라, 모델을 둘러싼 코드와 권한과 검증이 성능의 일부가 됐다는 사실인 것 같다. 아직 직접 API로 오래 써보지는 못했다. 써보고 나면 다시 정리해 볼 생각이다.
Comments 0
No comments yet. Be the first!